
1. Problema estatístico
| Conceito | Significado |
|---|---|
| População | Conjunto que se pretende estudar |
| Amostra | Parte da população que é observada; deve ser representativa |
| Variável | Característica em estudo |
| Dados discretos | Valores isolados, em geral resultantes de contagens |
| Dados contínuos | Valores num intervalo, em geral resultantes de medições |
Fases de um procedimento estatístico: produção de dados; organização e representação; interpretação. Inferir para a população a partir de uma amostra envolve incerteza.
2. Organização e representação
• Frequências: absoluta (\({n}_{i}\)), relativa \(\left( {f}_{i}=\frac{{n}_{i}}{n} \right)\), e respetivas frequências acumuladas.
• Gráficos: gráfico de barras, caule-e-folhas, histograma e diagrama de extremos e quartis.
• Histograma: é um diagrama de áreas, construído com classes de igual amplitude.
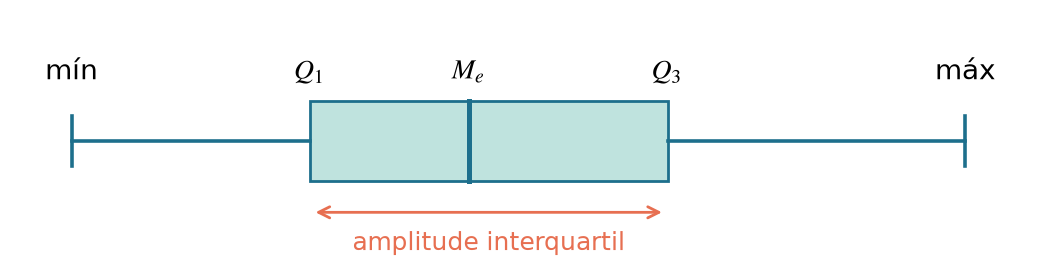
• Diagrama de extremos e quartis: mostra \(\min \), \({Q}_{1}\), \({Q}_{2}\), \({Q}_{3}\) e \(\max \), e é adequado para comparar distribuições.
3. Medidas de localização
| Medida | Como se obtém |
|---|---|
| Média | \(\overline{x}=\frac{{x}_{1}+{x}_{2}+\ldots +{x}_{n}}{n}\) |
| Mediana | Valor central dos dados ordenados; se \(n\) for par, média dos dois valores centrais |
| Moda | Valor, ou valores, com maior frequência |
| Quartis | \({Q}_{1}\), \({Q}_{2}={M}_{e}\) e \({Q}_{3}\) dividem os dados ordenados em quatro partes |
| Percentil \({P}_{k}\) | Valor que deixa, pelo menos, \(k\%\) dos dados ordenados até si |
Com dados agrupados em classes, usa-se o ponto médio de cada classe: \(\overline{x}\approx \frac{\sum {n}_{i}{c}_{i}}{n}\).
4. Medidas de dispersão
| Medida | Como se obtém |
|---|---|
| Amplitude | \(\max -\min \) |
| Amplitude interquartil | \({Q}_{3}-{Q}_{1}\) |
| Variância amostral | \({s}^{2}=\frac{\sum ({x}_{i}-\overline{x}{)}^{2}}{n-1}\) |
| Desvio padrão amostral | \(s=\sqrt{{s}^{2}}\) |
5. Propriedades
| Transformação dos dados | Efeito |
|---|---|
| \({y}_{i}={x}_{i}+b\) | \(\overline{y}=\overline{x}+b\); \({s}_{y}={s}_{x}\) |
| \({y}_{i}=a{x}_{i}\) | \(\overline{y}=a\overline{x}\); \({s}_{y}=|a|{s}_{x}\) |
• A soma dos desvios em relação à média é zero: \(\sum ({x}_{i}-\overline{x})=0\).
• \(s=0\) se e só se todos os dados forem iguais.
• A amplitude interquartil pode ser zero, sem que todos os dados sejam iguais.
• A média e o desvio padrão são pouco resistentes a valores extremos. Nesses casos, são preferíveis a mediana e a amplitude interquartil.
6. Dados bivariados
| Noção | Interpretação |
|---|---|
| Diagrama de dispersão | Mostra a forma, a direção e a força da associação |
| Coeficiente de correlação linear, \(r\) | \(-1\le r\le 1\). O sinal dá a direção; a proximidade de \(\pm 1\) dá a força da associação linear |
| Reta de regressão, \(y=ax+b\) | Obtida com a tecnologia; passa no ponto \((\overline{x},\overline{y})\) |
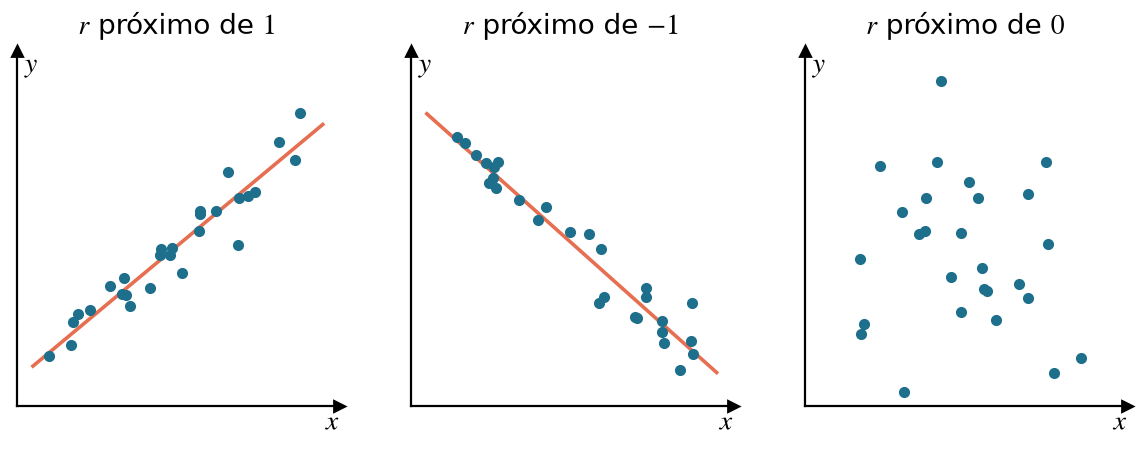
• A reta serve para prever \(y\) quando a associação linear é forte e \(x\) está no domínio dos dados.
• Correlação não significa relação de causa-efeito.
• A escolha da variável independente altera a reta de regressão, e os valores extremos influenciam \(r\) e a reta.
Exemplo resolvido
Dados: \(4\), \(6\), \(6\), \(8\), \(11\).
1. \(\overline{x}=\frac{35}{5}=7\), \({M}_{e}=6\) e moda \(=6\).
2. Soma dos quadrados dos desvios: \(9+1+1+1+16=28\).
3. \({s}^{2}=\frac{28}{4}=7\), pelo que \(s=\sqrt{7}\approx 2,65\).
4. Se cada dado aumentar \(10\%\) (multiplicação por \(1,1\)): \(\overline{y}=7,7\) e \({s}_{y}\approx 2,91\).
Como costuma sair no exame
– Texto para completar ou afirmações sobre uma tabela de dados.
– Cálculo da média ou do desvio padrão com a calculadora.
– Correlação e reta de regressão com a calculadora, seguidas de uma previsão.
– Percentagem de dados num intervalo como \(]\overline{x},\overline{x}+s[\).
– Efeito de uma transformação dos dados na média e no desvio padrão.
Erros frequentes
– Calcular a mediana sem ordenar os dados.
– Usar a soma dos desvios para medir a dispersão: essa soma é sempre zero.
– Confundir \(x\) e \(y\) ao introduzir os dados na calculadora.
– Prever para valores de \(x\) fora do domínio dos dados.
– Concluir causa-efeito a partir de uma correlação forte.
Âmbito
– O coeficiente de correlação e a reta de regressão obtêm-se com a tecnologia.
– Com dados agrupados, a média e o desvio padrão são valores aproximados.